为什么 mRNA Display 特别适合非天然氨基酸和环肽发现?
mRNA Display的优势不只是超大文库,而是把基因型–表型连接、无细胞翻译、遗传密码重编程、非天然氨基酸掺入与环化筛选组合为一个可迭代体系。
为什么 mRNA Display 特别适合非天然氨基酸和环肽发现?
多肽发现真正困难的,并不只是“生成更多序列”。当目标是获得高亲和力结合肽、蛋白酶耐受多肽、构象受限肽、环肽或含非天然氨基酸(noncanonical amino acids,NCAAs)的候选物时,核心问题变成:怎样构建一个具有真实化学意义的文库,同时让其中的分子仍然可以被翻译、筛选、解码、重新合成和实验验证?
mRNA Display 特别适合这个问题,因为它把四种能力连接在同一个实验体系中:genotype–phenotype linkage、cell-free translation、genetic code reprogramming 和迭代式 affinity selection。因此,它的价值不只是 library 很大,而是能够把预先定义的 chemical diversity 放进一个可追踪的筛选流程。
核心机制:让多肽携带自己的序列身份
在 mRNA Display 中,mRNA 模板通过合适的 linker 与 puromycin 相连。在体外翻译过程中,puromycin 接受新生多肽链,形成共价的 mRNA–peptide fusion。被测试结合能力的是 peptide phenotype,与其相连的核酸则保留能够识别它的 genotype。
文库接触靶标后,保留下来的分子可以通过核酸部分被回收、逆转录、扩增和测序。这就是 phenotype 能够追溯到 sequence 的基础。mRNA Display 不应与 ribosome display 混淆:后者依靠核糖体维持非共价复合物;它也不同于 phage display,后者由生物颗粒展示多肽或蛋白。
一个代表性的流程是:
DNA / mRNA library → 无细胞翻译 → mRNA–peptide fusion → NCAA 掺入和/或环化 → positive selection 与 counter-selection → 回收 → RT–PCR → 下一轮 → 测序
超大文库为什么重要,又为什么不是全部答案
即使只使用20种天然氨基酸,一个20-mer多肽的理论序列空间也达到20²⁰。加入NCAA、不同环拓扑和骨架修饰后,组合空间会进一步扩大,任何实际实验都不可能穷举。
在合适条件下,mRNA Display 可以处理约10¹²–10¹³量级的文库。这个量级的意义,是让筛选能够在比许多细胞依赖型体系更广的候选群体中工作。但名义多样性不等于有效多样性:寡核苷酸合成、转录、aminoacylation、翻译、fusion效率、环化、回收和扩增,都可能在真正测量靶标结合之前重塑文库组成。
因此,实际目标不是“覆盖全部化学空间”,而是设计一个足够大、化学目的明确、实验上可到达,并且与筛选条件相容的文库。
无细胞翻译改变了文库设计规则
mRNA Display 的翻译发生在活细胞之外,文库成员不需要被宿主细胞耐受,不需要跨越细胞膜,也不必经历细胞内稳定性和转化效率的限制。更重要的是,研究者可以调整 translation mixture:移除某些天然氨基酸、重新分配 codon、补充 aminoacyl-tRNA,或工程化翻译组分。
这种可控性为 genetic code reprogramming 提供了基础。根据所用体系,可以通过预先充载的 engineered tRNA、flexizyme-based aminoacylation,或工程化 aminoacyl-tRNA synthetase/tRNA 对,把空置 codon 或 stop codon 重新指定给选择的 NCAA。随后,核糖体在文库合成过程中把这些 building block 放到编码位置。
Li、Millward 与 Roberts 在2002年报道了mRNA Display中这一思路的早期实证:他们利用amber stop-codon suppression把biocytin掺入mRNA Display文库,并通过streptavidin选择富集相应模板。这个实验使用的化学功能较简单,但它证明了可遗传寻址的非天然功能可以进入一个既能被筛选、又能被扩增的mRNA Display群体。
这里最重要的区别是:chemical diversity 在筛选发生时已经存在于 library 中。 研究者不必先筛一个完全由天然氨基酸组成的线性肽,再对少数 hit 逐个进行后期化学修饰。
化学上可以买到,不等于核糖体可以掺入
一种可购买、可用于固相多肽合成(SPPS)的 building block,并不自动适合核糖体合成。要在超大文库中可靠掺入,至少需要通过几道关口:
- 单体能够以有用的效率装载到相容 tRNA 上;
- aminoacyl-tRNA 在翻译环境中具有足够稳定性和相容性;
- EF-Tu 或相关递送系统能够接受它;
- 核糖体能够完成肽键形成并继续延伸;
- 在预期 sequence context 中,掺入效率与 fidelity 仍足以支撑筛选。
这些限制具有残基和序列环境依赖性。单次掺入能够工作,不代表连续或多次掺入也同样有效。大体积侧链、改变的主链、D-氨基酸、β/γ-氨基酸和N-甲基化单体面对的障碍并不相同。因此,mRNA Display 的 NCAA library 应建立在有实验依据的 translation chemistry 上,而不是直接从供应商目录中任意选取单体。
NCAA 为多肽发现增加了什么
NCAA 可以引入天然氨基酸字母表难以覆盖的性质。例如D-构型、主链N-甲基化、α,α-二取代、更大的芳香表面、改变的电荷位置、反应性手柄或预组织的构象偏好。
这些变化可以支持多种设计假设:
- 降低特定蛋白酶的识别和切割;
- 限制局部或整体构象;
- 建立新的疏水、芳香、静电或共价相互作用;
- 改变溶解性和膜相互作用行为;
- 引入与文库相容的 macrocyclization 手柄。
但这些都不是性质保证。D-氨基酸可能破坏结合几何;N-甲基化可能移除必需的主链氢键供体;增加疏水表面可能带来非特异结合或聚集。必须把NCAA种类、位置、邻近残基、环拓扑和选择条件放在一起解释。关于display体系之外的设计原则,可进一步阅读《非天然氨基酸如何用于多肽优化:不只是提高稳定性》和《非天然氨基酸在药物开发中的作用》。
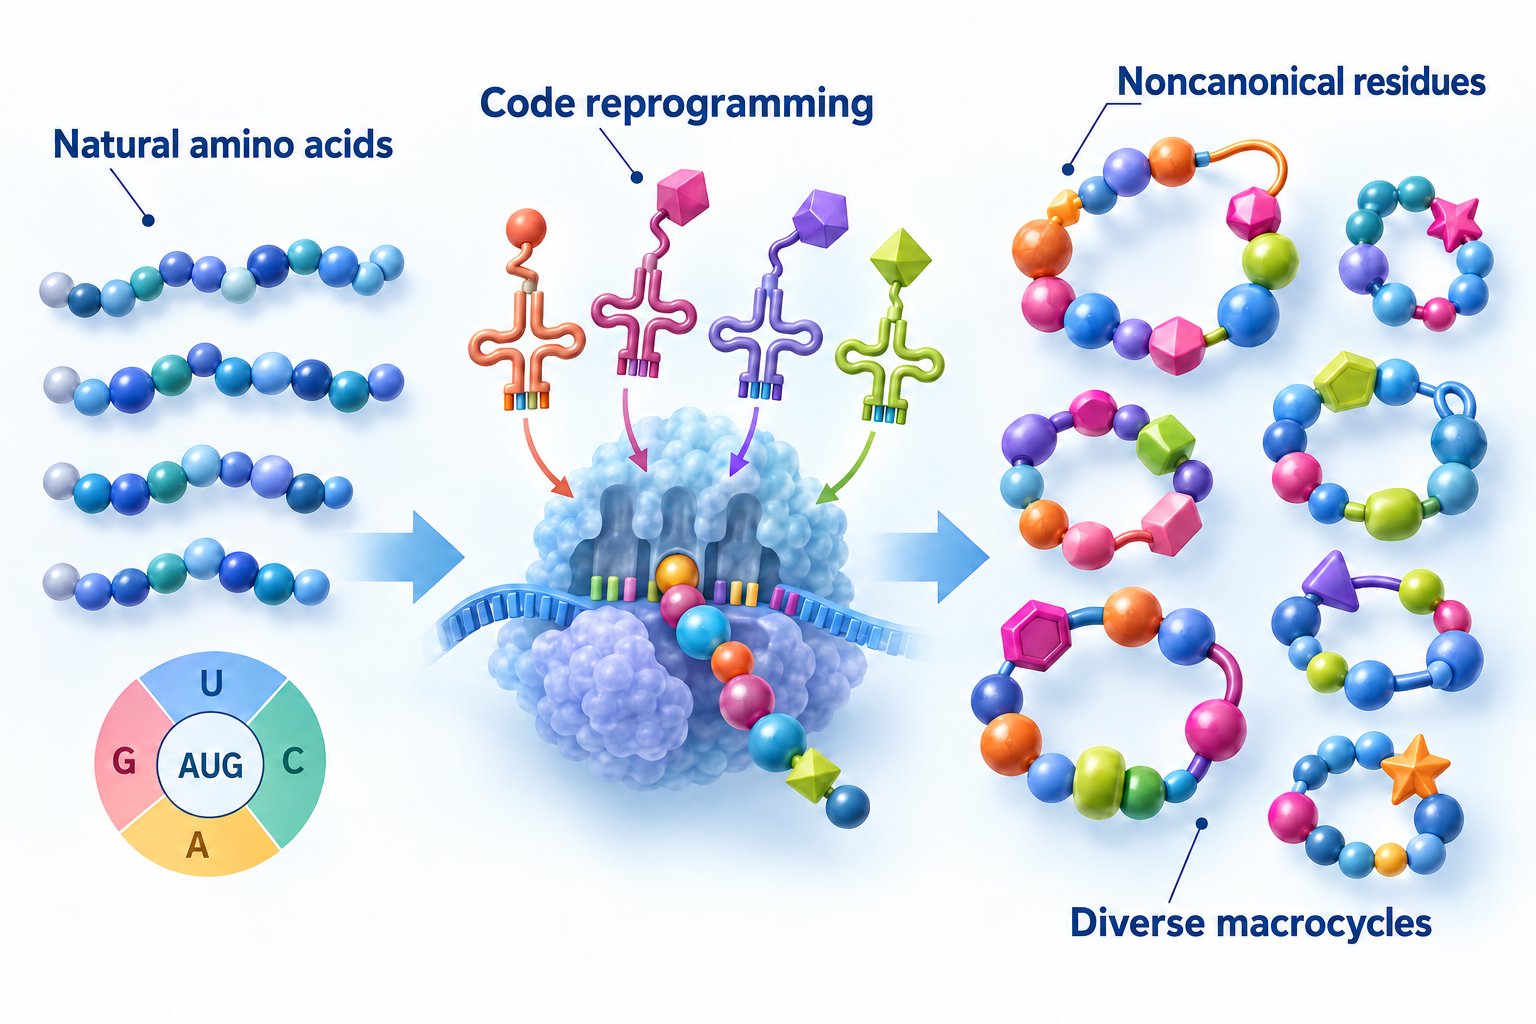
图1. 遗传密码重编程可把经过选择的非天然残基放进翻译文库,随后在文库层面完成环化,并以化学多样化的宏环分子作为直接筛选对象。
为什么 mRNA Display 特别适合环肽
环化可以减少线性肽链的构象自由度,并可能把分子预组织到有利于结合的几何状态。在合适的情况下,环肽可以提供比传统小分子更大的相互作用表面,同时保持相对明确的结构和介于小分子与大蛋白之间的尺寸。这使它们有机会接触较浅或较延展的蛋白表面,包括一些对常规小分子筛选较困难的 protein–protein interaction 界面。
更关键的优势是,环化可以发生在 library 层面。翻译后的多肽可以通过自发或程序化闭环、cysteine-based chemistry、electrophile-mediated cyclization 或其他相容的翻译后反应形成环。筛选直接作用于实际的 cyclic molecule,而不是先筛线性前体,再到后期猜测如何环化。
NCAA 与 cyclization 组合后,可以同时改变侧链化学、主链构象、ring topology、蛋白酶敏感性和靶标接触几何。这使受限多肽文库更丰富,也提出更高的质量控制要求:不同序列的环化效率可能不同,副反应可能出现,实际展示的产物分布也可能偏离设计分布。
关于环大小、锚定位点、拓扑和合成路线,可参阅《从线性肽到环肽:什么时候值得进行环化设计?》。
Positive selection 与 counter-selection 如何塑造选择性
典型 positive selection 会保留与靶标结合的文库成员,并通过洗涤移除较弱或不结合的分子。但“能绑定target”通常不够。序列可能结合固相载体、亲和标签、封闭试剂、基质中的高丰度成分或同源蛋白。
Negative selection 或 counter-selection 可以在positive selection之前或同时去除这些群体。对照对象可以是空白磁珠、无关蛋白、近缘同源物或与实验基质匹配的control。应根据生物学问题选择counter-target:去除同源蛋白结合有助于提高selectivity,但过强的counter-selection也可能丢失有价值的交叉反应家族。
每一轮筛选真正改变的是sequence distribution。最有信息量的输出不只是最终一轮的序列清单,而是enrichment trajectory、depleted population、family formation、motif conservation、position preference,以及序列在positive和negative压力下的不同行为。
为什么这些数据适合支持计算模型
逐轮测序可以提供比单一“hit/non-hit”标签更丰富的监督信息。在对照和metadata充分时,数据可包括富集序列、耗竭序列、counter-selection行为、单体身份、环化格式、序列家族、位点偏好和后续验证结果。
这些信息可以支持聚类、enrichment prediction、candidate ranking、sequence optimization、generative design 和实验优先级排序。但模型必须尊重文库化学以及筛选过程的bias:enrichment不是跨体系通用的亲和力标签,不同campaign的counts也不能自动直接比较,计算预测更不能替代重新合成和正交实验。下游设计可进一步参考《已有一个多肽,AI可以如何优化它?》和《AI设计的多肽,为什么还必须经过“可合成性”筛选?》。
必须正视的技术限制
mRNA Display 的强大来自多个分子过程被耦合在一起,而每一个过程也都可能引入bias。
- Translation bias:不同序列和单体的翻译或fusion效率不同。
- Aminoacylation bias:charged tRNA的产率和质量会影响NCAA掺入。
- Cyclization bias:不同序列形成目标环化产物的速率和产率并不相同。
- Selection artifacts:基质结合、聚集、靶标展示方式、avidity和洗涤条件都可能产生误导性富集。
- PCR / sequencing bias:扩增和读出会扭曲表观丰度。
- Binding is not development:筛选得到的binder还不是drug candidate。
这些限制要求加入对照、重复分析、逐轮测序、独立重合成与正交验证,而不是放弃该平台。
从 selection hit 到定义明确的实验多肽
一个实际的hit-to-lead路径通常包括:
序列确认 → 独立化学重合成 → 身份与纯度分析 → 结合验证 → 功能实验 → 结构/SAR分析 → NCAA与环化优化 → 溶解性、稳定性和可合成性评估 → 项目相关药理研究
这一步转换非常重要,因为display-library chemistry最终需要变成结构明确、可纯化的实验材料。一个序列可能强烈富集,却在重合成时失败;也可能形成不同的环化产物、离开展示构建体后失去活性,或表现出较差溶解性。因此,定制合成和分析质量控制是discovery的一部分,而不是无关的后续事务。实际制造考虑可参阅《定制多肽合成完整指南》。
mRNA Display 与 phage display 服务于不同设计空间
Phage display 仍是成熟且有价值的技术。mRNA Display 的差异在于cell-free、能够支持非常大的文库,并且更容易接入某些genetic-code-reprogramming策略。这些特点让它更适合部分NCAA-rich和macrocyclic library设计,但不意味着它在所有情况下都更优。靶标形式、scaffold、实验条件、所需化学空间与下游用途,共同决定应该选择哪种display technology。
总结
mRNA Display 的价值不只是能够构建很大的多肽库,而是能够把遗传编码、无细胞翻译、经过选择的非天然氨基酸、相容的环化化学、亲和筛选和序列恢复结合在同一个可迭代体系中。
对含NCAA的环肽而言,真正重要的不是为了数量而产生更多序列,而是建立一个可编码、可翻译、可环化、可筛选、可重新合成和可实验验证的化学空间。
参考文献
- Roberts RW, Szostak JW. RNA-peptide fusions for the in vitro selection of peptides and proteins. PNAS. 1997;94:12297–12302. doi:10.1073/pnas.94.23.12297
- Li S, Millward S, Roberts RW. In Vitro Selection of mRNA Display Libraries Containing an Unnatural Amino Acid. Journal of the American Chemical Society. 2002;124:9972–9973. doi:10.1021/ja026789q
- Kamalinia G, et al. Directing evolution of novel ligands by mRNA display. Chemical Society Reviews. 2021;50:9055–9103. doi:10.1039/D1CS00160D
- Josephson K, Ricardo A, Szostak JW. mRNA display: from basic principles to macrocycle drug discovery. Drug Discovery Today. 2014;19:388–399. doi:10.1016/j.drudis.2013.10.011
- Yamagishi Y, et al. Natural Product-Like Macrocyclic N-Methyl-Peptide Inhibitors against a Ubiquitin Ligase Uncovered from a Ribosome-Expressed De Novo Library. Chemistry & Biology. 2011;18:1562–1570. doi:10.1016/j.chembiol.2011.09.013
- Peacock H, Suga H. Discovery of De Novo Macrocyclic Peptides by Messenger RNA Display. Trends in Pharmacological Sciences. 2021;42:385–397. doi:10.1016/j.tips.2021.02.004
- Goto Y, Suga H. The RaPID Platform for the Discovery of Pseudo-Natural Macrocyclic Peptides. Accounts of Chemical Research. 2021;54:3604–3617. doi:10.1021/acs.accounts.1c00391
- Iskandar SE, et al. Enabling Genetic Code Expansion and Peptide Macrocyclization in mRNA Display via a Promiscuous Orthogonal Aminoacyl-tRNA Synthetase. Journal of the American Chemical Society. 2023;145:1512–1517. doi:10.1021/jacs.2c11294
- Katoh T, Suga H. Reprogramming the genetic code with flexizymes. Nature Reviews Chemistry. 2024;8:879–892. doi:10.1038/s41570-024-00656-5
想了解非天然氨基酸环肽的发现与后续优化?
如果您的项目涉及蛋白靶点、多肽hit、环肽或非天然氨基酸设计,我们可以从候选设计、结构与化学可行性评估,到多肽定制合成、纯化和质量分析提供进一步支持。