从随机肽库到候选肽:mRNA Display 一轮筛选到底发生了什么?
一轮mRNA Display筛选不仅是结合、洗涤和扩增,而是从文库设计、翻译和融合,到靶标选择、反筛选、PCR与NGS的一系列群体过滤过程。
从随机肽库到候选肽:mRNA Display 一轮筛选到底发生了什么?
很多人把display screening理解成“从一个巨大的文库里找出结合最强的几个序列”。更准确地说,一轮mRNA Display selection是一个分子群体连续经历多重转换和选择压力的过程。每一步都会改变哪些序列最终还能被观察到。
最终丰度受到initial representation、转录、翻译、fusion形成、非天然氨基酸(noncanonical amino acids,NCAAs)掺入、化学成熟、靶标结合、非特异滞留、洗涤、回收、扩增和测序深度共同影响。一个序列在final pool中变多,可能提示它值得关注,但abundance本身并不能证明高亲和力。
本文在方法学层面跟踪一轮代表性筛选。不同平台的具体顺序会有差异:reverse transcription可以发生在靶标选择之前或之后,天然线性肽库也未必需要化学成熟步骤。主线始终相同:回收到的sequence distribution是selection与molecular processing共同塑造的复合输出。
一轮筛选的全流程
| 阶段 | 发生什么 | 群体发生什么变化 |
|---|---|---|
| Library design | 定义可变位点、codon、固定motif、NCAA分配和环化锚点 | 实验开始前就限定可到达的序列与化学空间 |
| Transcription | DNA模板转录为RNA | 产率、截短产物和RNA完整性可能改变representation |
| Translation | RNA在无细胞体系中产生多肽 | codon环境、stalling、tRNA供给与单体兼容性影响peptide output |
| Fusion formation | 多肽与编码它的mRNA形成共价连接 | 不同fusion效率决定哪些genotype–phenotype对进入筛选 |
| Chemical maturation | 可选的脱保护、环化、氧化或化学选择性转化形成预期分子 | 不完全或序列依赖的转化会带来产物异质性 |
| Target selection | 文库接触被展示的靶标 | 靶标状态和筛选条件定义哪些相互作用被偏好 |
| Washing / counter-selection | 差异化移除弱结合、快解离、载体结合、标签结合或off-target分子 | stringency和对照设计共同塑造signal-to-background与specificity |
| Recovery | 回收保留的genotype-linked molecules | 洗脱与回收效率可能再次偏向某些分子 |
| RT–PCR / amplification | 遗传信息被转换并扩增 | 模板结构、GC含量、随机瓶颈与PCR效率可能扭曲丰度 |
| NGS / analysis | 统计序列、家族、富集和耗竭 | read depth和分析方法决定能够分辨哪些trajectory |
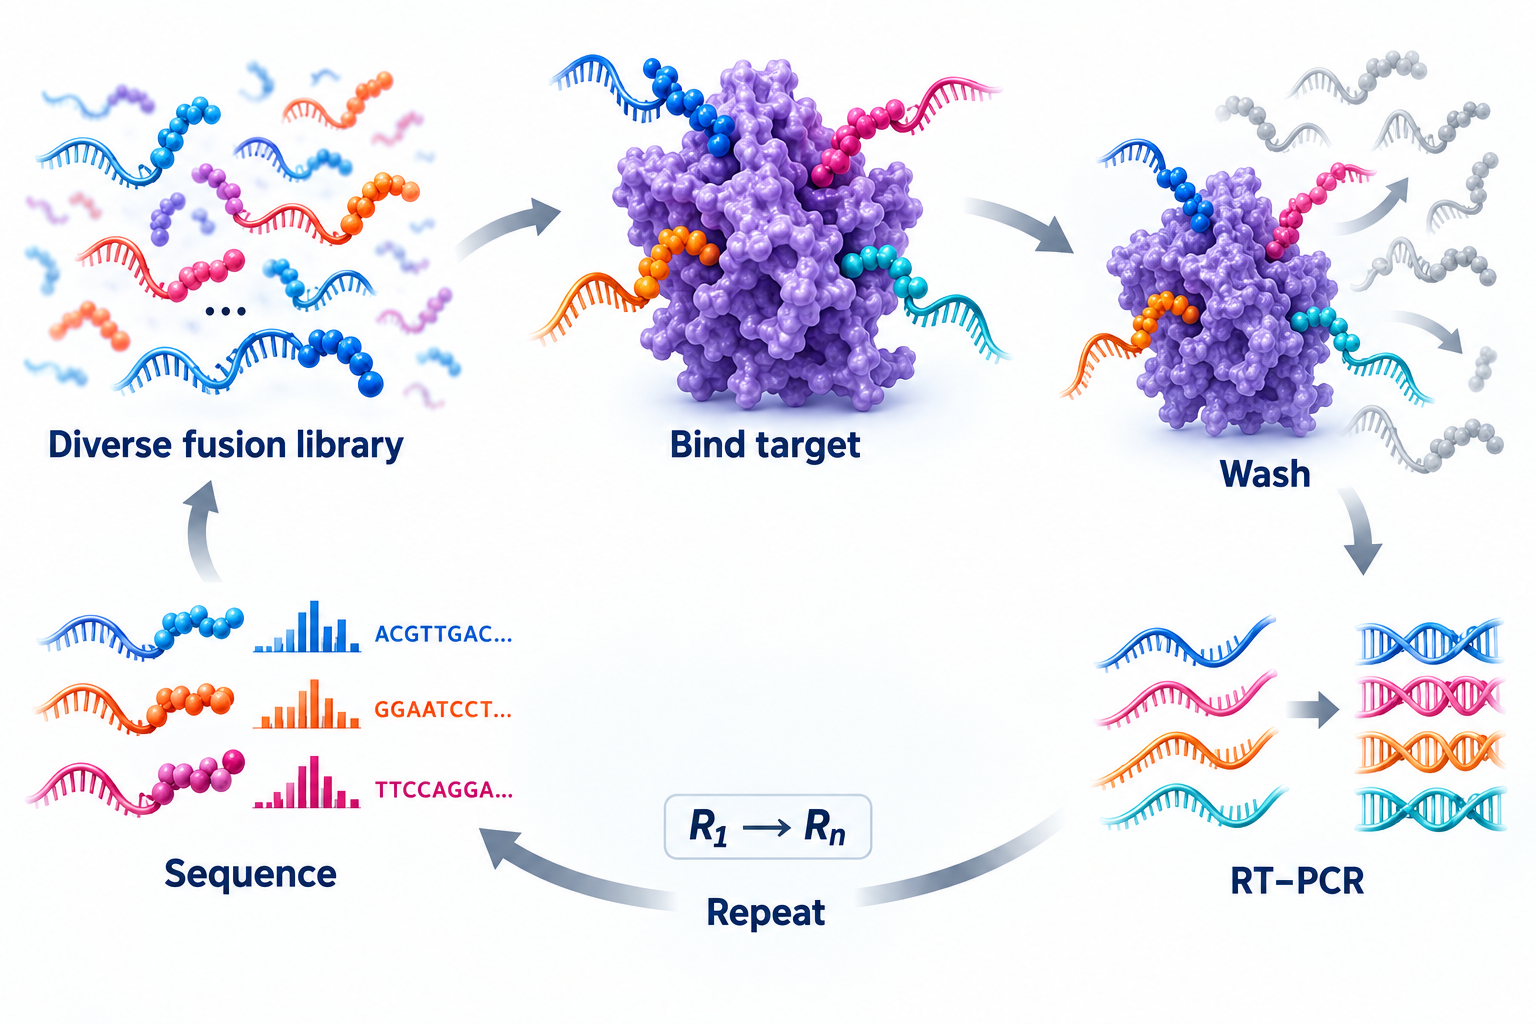
图1. 代表性的mRNA Display筛选循环。箭头描述实验流程,但每一个步骤的输出同时也是被技术和生化过滤器重新塑造的群体。
第一步:selection从library design就已经开始
在文库接触靶标之前,selection pressure已经由设计限定。随机区域长度、codon design、固定位置、scaffold、环化锚点、NCAA codon allocation和序列约束,共同决定实验里什么分子有机会存在。
理论diversity不等于物理diversity。简并设计能够描述的可能序列,通常远多于实际可合成和处理的分子数。即使设计目标是让每种残基等概率出现,寡核苷酸合成和模板构建也可能产生不均匀的起始representation。物理输入中不存在的序列,后续选择无法把它“找回来”。
因此,有价值的数据分析应尽量包含round zero或其他input pool表征。判断enrichment要看一个序列从哪里开始,而不能只看最后到达哪里。
关于NCAA和环肽文库的设计逻辑,可参阅《为什么 mRNA Display 特别适合非天然氨基酸和环肽发现?》;genotype–phenotype linkage的基础介绍见《mRNA Display:从超大规模多肽库中发现高亲和力分子》。
第二步:transcription在筛选前改变representation
DNA模板经转录形成RNA library。序列依赖的产率、不完整产物和RNA完整性差异,都可能改变进入翻译阶段的群体。它们不是靶标结合事件,却会影响哪些模板有机会产生peptide。
这是一种单向约束:一个序列如果在转录或纯化时已经丢失或严重不足,后续selection无法展示它本来可能具有的结合能力。因此,核酸阶段的quality control也是解释最终多肽群体的一部分。
第三步:translated library可能不同于designed library
不同模板的translation efficiency并不完全相同。Codon context、困难序列特征、ribosome stalling、charged-tRNA可用性和多肽性质都会影响有效合成。对于NCAA library,设计中分配了某个codon,不代表每一种sequence context都能以同样频率完成掺入。
Aminoacylation效率、tRNA相容性、递送到核糖体的效率以及ribosomal acceptance都会产生影响。连续或相邻掺入也可能与单个NCAA不同。因此,实验中真正相关的是translated peptide library,而不只是设计出来的DNA library。
第四步:fusion决定哪些分子可以被追踪
mRNA Display依赖genotype–phenotype linkage。常见实现使用含puromycin的linker,让新生多肽在翻译过程中与编码它的mRNA形成共价连接,从而能通过genotype回收被选中的phenotype。
Fusion formation本身也是一个过滤器。如果不同模板形成稳定mRNA–peptide fusion的概率不同,一些序列在接触靶标之前就可能被系统性低估。检查整体fusion performance有助于区分“筛选没有信号”和“fusion制备本身效率不足”,但整体合格也不意味着每个成员效率完全相同。
第五步:chemical maturation形成真正被筛选的分子
对于含NCAA或环肽文库,translation未必是文库构建的终点。后续可能需要脱保护、自发或诱导环化、氧化、chemoselective ligation或其他相容的翻译后转化。
Selection应尽可能作用于预期的mature chemical species。如果闭环不完整或具有sequence dependence,群体中可能同时存在未环化前体、目标macrocycle和副产物,它们的结合与回收行为不同。此时看到的sequence enrichment可能同时包含生物识别和chemical conversion efficiency。
因此,解释NCAA与cyclic library时,除了sequence identity,还需考虑codon reassignment fidelity、incorporation efficiency、cyclization conversion和mature-product heterogeneity。
第六步:target incubation定义被选择的phenotype
成熟的fusion library与固定化或以其他方式展示的target接触。Target concentration、presentation、accessibility、conformation和incubation regime共同决定哪些binder能够被保留。
较高target concentration可能允许较弱相互作用留下;降低浓度可以提高压力,却也可能降低可回收信号。改变接触时间还可能偏向不同kinetic behavior。因此不能把“target越低越好”当作通用规则。条件应围绕预期选择目标和可区分的signal-to-background设计。
Target quality比筛选轮数更基础
错误的target preparation无法由精细筛选补救。Folding、oligomeric state、post-translational modification、active conformation、immobilization orientation与tag exposure都值得评估。固定在表面的target可能意外富集matrix、linker、tag、暴露疏水面或非天然构象的binder。
Target control不是行政性细节,而是实验信息。它定义了本次campaign中“specific binding”可能意味着什么。
第七步:positive selection与counter-selection承担不同任务
Positive selection保留能够在intended target上存活的文库成员。单独使用时,它也可能富集bead/resin binder、tag binder、疏水sticky peptide、核酸相互作用artifact,或识别基质中无关蛋白的分子。
Negative selection或counter-selection用于移除明确不希望出现的群体。例如,文库可以先接触blank matrix以耗竭matrix-binding sequence,也可以先接触同源蛋白或off-target,减少交叉反应family,再进入目标靶标的positive selection。
因此,specificity可以在selection strategy中主动设计。对Target A做positive selection,同时对Target B做depletion,可能逐步偏向A-selective behavior;但这仍不能单独证明选择性,最后必须用A、B和相关对照进行独立实验。
第八步:washing是可调节的selection pressure
Washing决定哪些bound species能够留下。它可以降低非特异背景、移除弱结合或快解离相互作用,但wash stringency不是简单的“越强越好”。
过强可能丢失有价值的binder,尤其是在campaign早期或target density与recovery受限时;过弱则可能让sticky peptide和背景相互作用主导后续扩增。真正需要优化的是预期结合模型下的signal-to-background。
第九步:recovery又增加了一层过滤
被保留的genotype-linked molecule还必须被回收。Recovery efficiency可能不同:弱binder可能已经在washing时丢失,非常持久的相互作用可能难以释放,也有些分子可能通过非目标机制滞留。
因此,recovered pool不是equilibrium affinity的纯测量,而是target association、洗涤中的dissociation、非特异滞留和回收方式共同作用的结果。
第十步:amplification保存信息,也可能扭曲信息
回收的遗传信息经reverse transcription和PCR amplification,产生下一轮或测序所需材料。PCR不可缺少,但GC含量、secondary structure、primer interaction等差异会让模板具有不同扩增效率。
当回收分子数很少时,stochastic bottleneck也很重要。某个序列可能因为早期抽样而看似扩张,真正的binder也可能偶然丢失。多轮重复扩增会累积这种差异。因此final read count不能直接解释成affinity或Kd。
第十一步:NGS测量的是composite observable
Next-generation sequencing(NGS)可以观察sequence abundance、enrichment、depletion、family structure、motif emergence与position preference。它的深度让研究者看到低通量测序难以捕获的trajectory。
但一个NGS count是复合观测值,包含input representation、molecular processing、selection、recovery、amplification、sampling depth和data processing的共同作用。Read count最高的序列不一定是best binder。
更有价值的解释会同时考虑:
- 起始和中间pool中的abundance;
- 相邻round之间的fold enrichment;
- replicate consistency;
- 是否属于独立富集的sequence family;
- 在counter-selection或off-target control中的行为;
- sequencing depth与不确定性;
- 独立biochemical validation。
一轮只是快照,多轮也不是越多越好
早期round通常背景较高,稀少的功能序列与technical noise混合存在。迭代筛选把回收并扩增的pool作为下一轮input,同时可以调整selection pressure。有价值的family可能逐渐清晰,但更多round并不自动更好:过度收敛可能损失diversity、放大扩增artifact,或偏向最容易传播而非最有功能的序列。
例如,Sequence A在Round 1丰度低,随后在Round 2、3、4持续增加,通常比只在最后一轮突然高丰度的Sequence B更值得分析。但这不是绝对规则,还要结合starting abundance、enrichment ratio、replicate consistency、family context、negative-selection behavior和sequencing coverage。
Sequence family通常比Top 10清单更有信息
筛选群体常包含相关sequence family,而不仅是孤立winner。Family成员可能共享binding motif、保守的电荷或疏水模式、ring topology或NCAA position。
高度保守位置可能参与靶标接触、结构组织或环化几何;可变位置则可能表示tolerance,并为后续structure–activity relationship(SAR)探索提供修改位点。Family-level view有助于把可重复的chemical pattern与单个高count outlier区分开。
Positive enrichment与negative depletion也应联合分析。一个family如果在目标靶标上富集、在counter-target上同样富集,就不能作为specificity的有力证据。
Replicate提高confidence
Selection和sequencing可能包含handling variation、amplification bias和stochastic bottleneck。在条件允许时,replicate selection或关键阶段重复有助于识别可重现的trajectory。重复不会自动消除bias,但能帮助区分稳定生物信号与一次性的群体事件。
全流程bias对照表
| 阶段 | 潜在bias | 解释风险 |
|---|---|---|
| Library synthesis | 起始representation不均匀 | 稀少或缺失设计无法被公平比较 |
| Transcription | 序列依赖产率、截短、RNA完整性 | 核酸损失可能看起来像negative selection |
| Translation | codon context、stalling、序列依赖产率 | 设计丰度不同于peptide abundance |
| NCAA incorporation | 充载与掺入效率不同 | codon存在不等于成熟产物确实含NCAA |
| Fusion formation | fusion效率不均 | 低fusion成员被系统性低估 |
| Cyclization / maturation | 不完全或序列依赖转化 | reads可能代表异质化学产物 |
| Target binding | target状态、展示、浓度、可及性 | enrichment可能偏向非预期target state |
| Washing | stringency与解离时间偏差 | 有用binder可能丢失,背景也可能残留 |
| Recovery | 释放或洗脱效率不均 | 被保留不等于能被有效回收 |
| RT–PCR | 模板结构、GC含量、随机瓶颈 | amplification advantage可能伪装成enrichment |
| Sequencing | sampling depth、错误、预处理选择 | 低频trajectory可能被遗漏或错误估计 |
Selection hit还不是validated free peptide
入选序列需要被独立resynthesis,确认mass与purity,并在脱离display construct后测试binding。随后还可能需要competition、functional、specificity、stability和项目相关的developability assay。
Resynthesis会打破genotype–phenotype system,并把多肽作为独立chemical entity进行测试。 这很重要,因为free peptide可能与mRNA-linked species表现不同,化学合成也可能暴露环化或NCAA掺入方面的结构歧义。
一个实际路径是:
enriched sequence → independent synthesis → binding validation → family analysis → SAR → NCAA与环化优化 → 稳定性、溶解性和可合成性评估 → next-generation candidate
mRNA Display是discovery engine,而不是完整drug-development process。后续设计可参阅《已有一个多肽,AI可以如何优化它?》、《AI设计的多肽,为什么还必须经过“可合成性”筛选?》和《定制多肽合成完整指南》。
为什么selection trajectory适合支持AI分析
最有价值的计算数据并不只是final winner清单,而可以包括initial sequence、round-by-round abundance、positive enrichment、negative depletion、family membership、positional conservation、library chemistry和selection conditions。
这些longitudinal、structured data可以支持candidate ranking、sequence–fitness modeling、motif discovery、实验优先级排序和generative peptide model training。但应用时仍需合理归一化、不确定性估计、chemical-aware representation和实验验证标签。后续文章将进一步讨论mRNA Display数据如何与AI辅助多肽设计结合。
总结
mRNA Display的价值不只是“从一个超大库里选出几个高丰度序列”。真正有价值的是理解一个多肽family如何在连续selection pressure下逐轮变化,以及哪些序列和化学特征与靶标结合、选择性和化学可执行性相关。
从library composition、translation、fusion formation和cyclization,到target selection、counter-selection、PCR与NGS,每一步都会塑造最终看到的数据。理解这些过滤器,才能把“富集序列”转化为真正值得重新合成和实验验证的候选肽。
参考文献
- Roberts RW, Szostak JW. RNA-peptide fusions for the in vitro selection of peptides and proteins. PNAS. 1997;94:12297–12302. doi:10.1073/pnas.94.23.12297
- Wilson DS, Keefe AD, Szostak JW. The use of mRNA display to select high-affinity protein-binding peptides. PNAS. 2001;98:3750–3755. doi:10.1073/pnas.061028198
- Kamalinia G, et al. Directing evolution of novel ligands by mRNA display. Chemical Society Reviews. 2021;50:9055–9103. doi:10.1039/D1CS00160D
- Newton MS, Cabezas-Perusse Y, Tong CL, Seelig B. In Vitro Selection of Peptides and Proteins—Advantages of mRNA Display. ACS Synthetic Biology. 2020;9:181–190. doi:10.1021/acssynbio.9b00419
- Blanco C, Verbanic S, Seelig B, Chen IA. High throughput sequencing of in vitro selections of mRNA-displayed peptides: data analysis and applications. Physical Chemistry Chemical Physics. 2020;22:6492–6506. doi:10.1039/C9CP05912A
- Li S, Millward S, Roberts RW. In Vitro Selection of mRNA Display Libraries Containing an Unnatural Amino Acid. Journal of the American Chemical Society. 2002;124:9972–9973. doi:10.1021/ja026789q
- Peacock H, Suga H. Discovery of De Novo Macrocyclic Peptides by Messenger RNA Display. Trends in Pharmacological Sciences. 2021;42:385–397. doi:10.1016/j.tips.2021.02.004
- Nishikawa S, et al. De Novo Single-Stranded RNA-Binding Peptides Discovered by Codon-Restricted mRNA Display. Biomacromolecules. 2024;25:355–365. doi:10.1021/acs.biomac.3c01024
已有靶点,希望开展多肽发现或候选优化?
如果您的项目涉及蛋白靶点、mRNA Display、环肽、非天然氨基酸或已有候选多肽,我们可以进一步提供候选设计、化学可行性评估、多肽定制合成、纯化和质量分析支持。