mRNA Display:从超大规模多肽库中发现高亲和力分子
mRNA Display通过嘌呤霉素介导的共价连接,让每条多肽携带自己的序列身份,从约10¹²–10¹³量级文库中迭代筛选结合分子,并为环肽、非天然氨基酸与数据驱动设计建立实验基础。
mRNA Display:从超大规模多肽库中发现高亲和力分子
mRNA Display 是一种把多肽与编码它的核酸序列物理连接起来的体外筛选技术。这个看似简洁的原理,使研究人员能够构建高度多样化的多肽文库,筛选与靶标结合的分子,再通过扩增和测序其所连接的遗传信息找回序列身份。
这一技术尤其适合环肽和含非天然氨基酸(noncanonical amino acids,NCAAs)多肽的发现。它的优势并不只来自文库规模,而是基因型—表型连接、可编程翻译化学、迭代筛选与测序共同构成了一个完整实验系统。
什么是 mRNA Display?
在 mRNA Display 中,mRNA 模板通过适当的 linker 与 puromycin(嘌呤霉素)连接。体外翻译进行到模板末端时,puromycin 可以进入核糖体的肽酰转移中心并接受正在延伸的多肽链,最终形成共价的 mRNA–peptide fusion。多肽是接受筛选的 phenotype,而与其相连的 mRNA 则保留能够识别该序列的 genotype。
这个共价连接是技术核心。多肽不是与一条无关 mRNA 非共价地靠在一起;每个被展示的 peptide 都携带编码自己的 sequence identity。筛选后,核酸部分可以经过逆转录、扩增与测序,让一次结合事件重新对应到具体多肽序列。
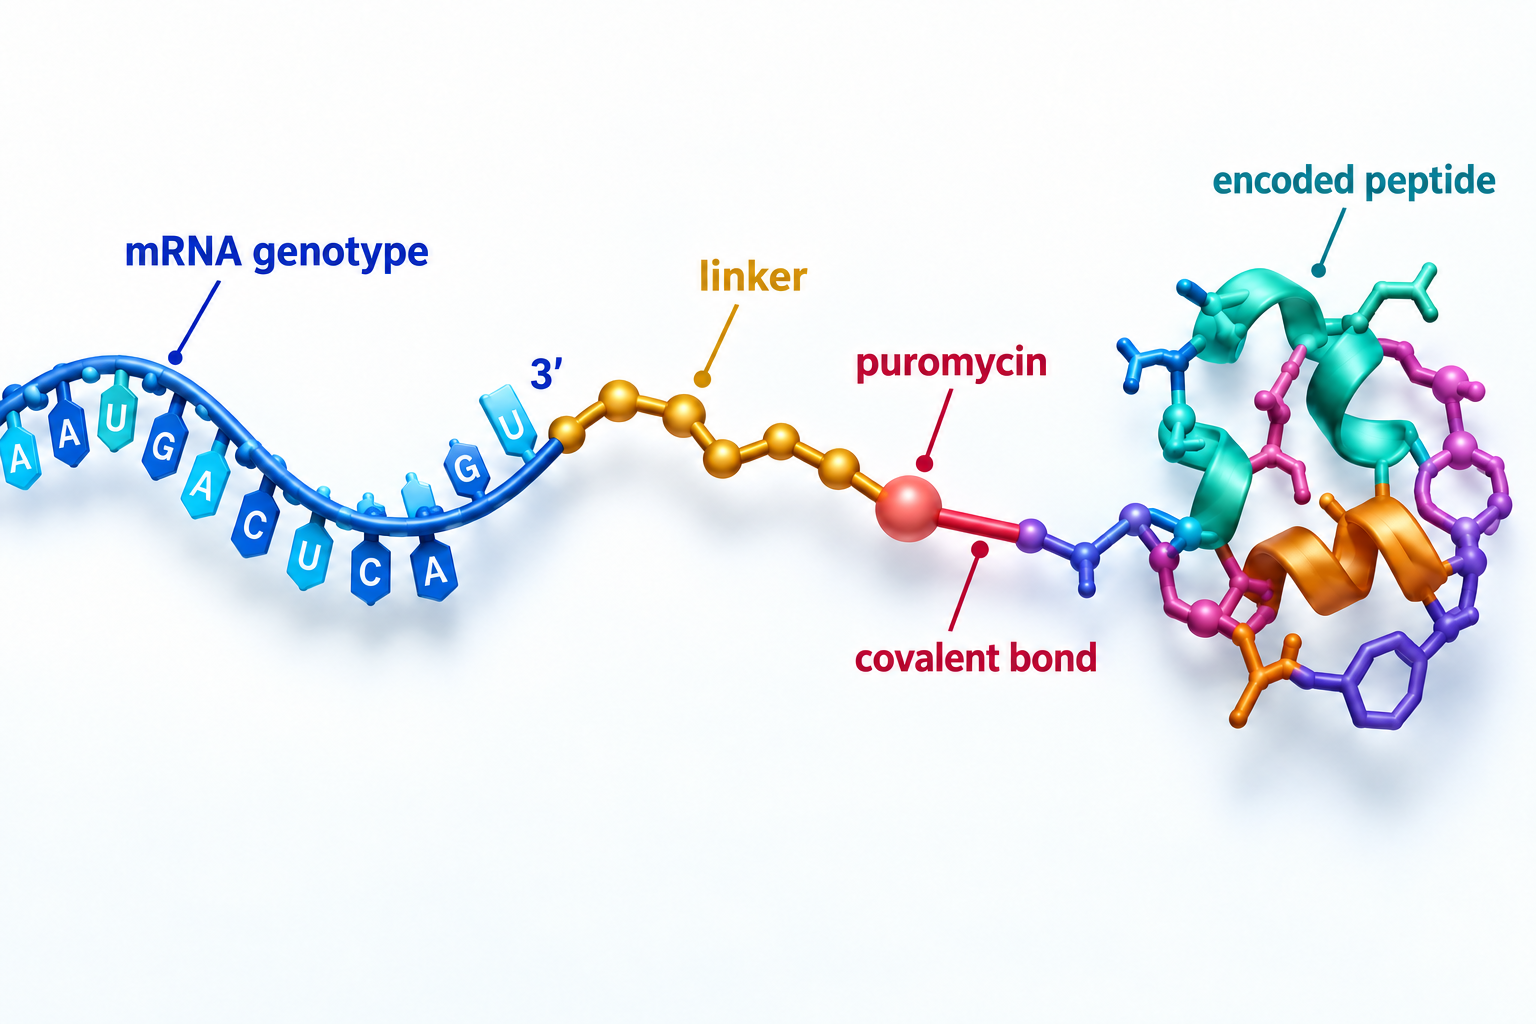
图1. mRNA Display 的基本原理。Puromycin 介导的共价连接让多肽表型与其序列身份保留在同一个分子上。
为什么能够建立超大规模多肽库?
mRNA Display 是 cell-free 的。依赖 cellular transformation 的展示体系,其实际文库规模会受到候选进入细胞并维持存活等步骤的约束;mRNA Display 则在体外生成并处理文库,不要求每个候选分别通过活细胞。
根据模板制备、翻译效率、fusion yield 与后续操作方式不同,mRNA Display 可以探索约 10¹²–10¹³ 量级的分子库。这是具有代表性的范围,不是每个实验都必然达到的固定规模。如果存在明显的合成偏差、翻译偏差、连接效率不足或样品损失,有效多样性可能低于名义输入量。
超大文库也不会自动产生有用配体。文库架构、靶标质量、筛选压力、反筛策略,以及区分特异性富集与背景的能力,同样决定结果质量。
一个代表性的 Selection Cycle
典型流程从 DNA library 开始,经转录生成 mRNA library。每条 mRNA 与 puromycin 连接,经过 in vitro translation 形成 mRNA–peptide fusion。融合文库与固定化或可分离的靶标接触,未结合分子通过 washing 去除,保留的 fusion 被回收、逆转录并扩增,进入下一轮。经过多轮选择后,next-generation sequencing 可以识别富集序列及其相关家族。
一个代表性的顺序是:
DNA library → transcription → mRNA library → puromycin linkage → in vitro translation → mRNA–peptide fusion → target selection → washing → recovery → reverse transcription / PCR → next round → sequencing
具体 protocol 会有差异。例如,逆转录可以安排在亲和选择之前或之后,不同体系也会采用不同的 fusion 纯化与回收步骤。因此,下图表达的是迭代筛选的逻辑,而不是声称所有 protocol 都必须采用完全相同的时序。
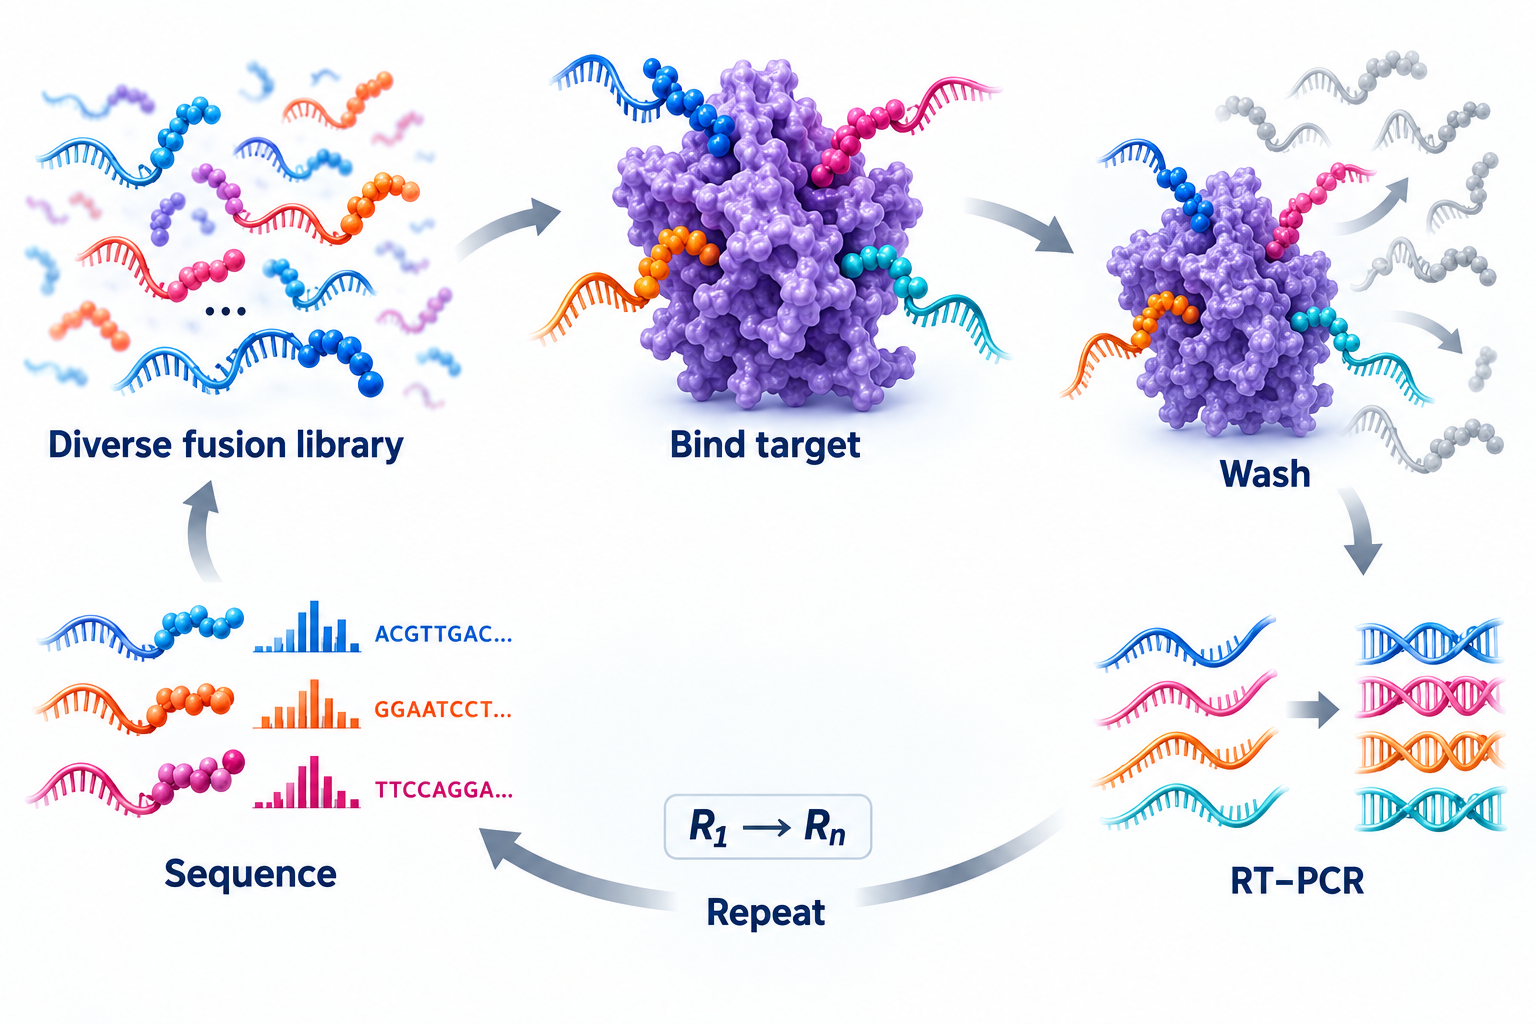
图2. 从超大规模文库到富集序列。筛选逐步集中可重复出现的结合分子;测序用于识别富集家族,但本身不等同于功能验证。
富集意味着什么,又不意味着什么?
Enrichment 表示某条序列或某个家族在给定选择条件下相对丰度提高。它可能反映靶标结合,也可能来自扩增偏差、非特异相互作用、磁珠结合,或异常高效的翻译与 fusion formation。因此,合理的 negative selection、重复筛选与 orthogonal assay 十分重要。
测序计数有助于确定候选优先级和观察 sequence–activity relationship,但它不是直接的 affinity measurement。入选多肽仍需独立合成,并根据项目需求完成结合、选择性、功能活性、溶解性和稳定性等实验表征。
从线性多肽到环肽
线性多肽在溶液中往往能够采样多种构象。Cyclization 可以减少可及的构象空间,并可能让多肽预组织到更接近结合态的构象。在合适体系中,这可以提高亲和力或选择性,也可以降低蛋白酶敏感性。但这些结果都不是必然的:错误的环拓扑可能破坏活性构象、引入环张力,或增加合成难度。
mRNA Display 可以与多种环化策略组合,前提是所用化学与文库兼容,并且不会破坏 genotype–phenotype linkage。Ring size、锚点位置、侧链朝向和靶标几何仍然需要设计。关于这些选择的实践方法,可参阅《从线性肽到环肽:什么时候值得进行环化设计?》。
为什么非天然氨基酸非常重要?
20 种天然氨基酸已经提供了丰富的序列空间,但不能覆盖配体发现所需的全部化学性质。非天然氨基酸可以扩展 side-chain chemistry、stereochemistry 与 backbone chemistry,改变构象偏好,引入环化手柄,并探索天然残基无法覆盖的理化性质与 proteolytic stability 空间。
相关类别可以包括 D-氨基酸、N-甲基氨基酸、α-取代氨基酸,以及具有多样化侧链化学的残基。但它们能否被引入取决于具体系统:不同 building block 需要匹配的 aminoacylation、tRNA、codon assignment 与翻译条件,不能假设同一种 charging mechanism 可以无条件地把任意 NCAA 放入任意 translation system。
因此,genetic code reprogramming 与工程化翻译系统扩展的不只是序列数量,更是筛选可以触及的 chemical space。其价值来自受控且经过实验支持的 incorporation,而不是把每一种可能的单体都视为可自由互换。
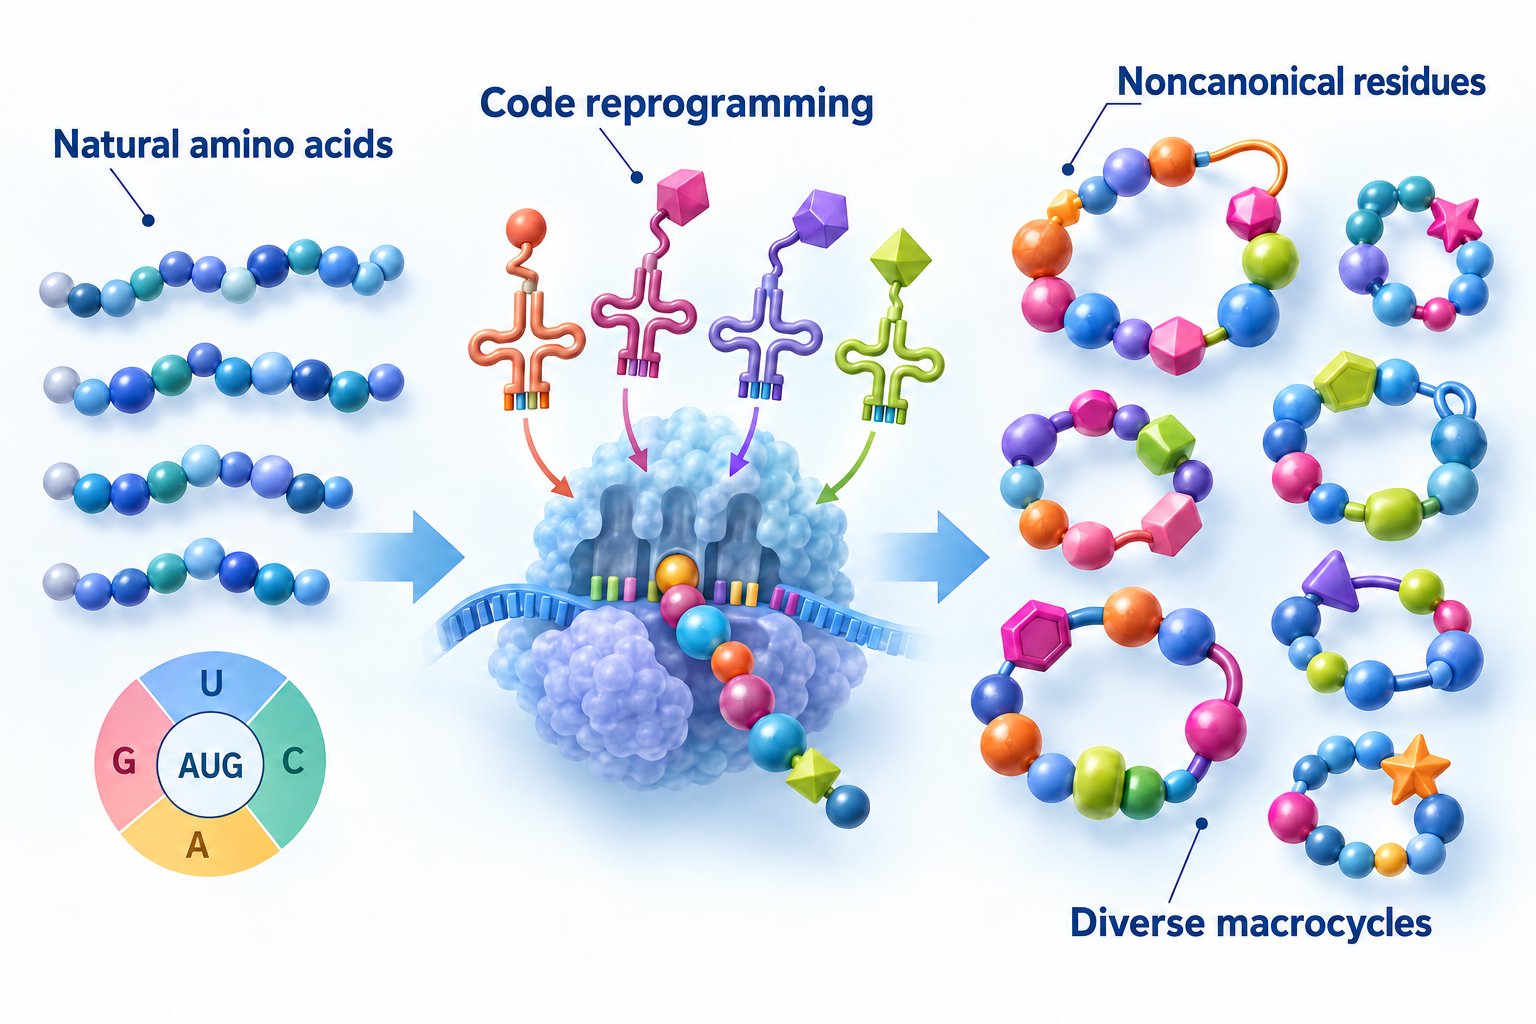
图3. 从天然氨基酸序列空间扩展到非天然环肽化学空间。扩展涉及残基化学、骨架和构象,而不仅仅是序列数量。
这些 building block 的更多设计考虑,可参阅《非天然氨基酸如何用于多肽优化:不只是提高稳定性》和《N-甲基氨基酸在多肽药物中的重要作用》。
mRNA Display 与 AI 可以怎样结合?
一次 mRNA Display 筛选能够产生的不只是“胜出序列”清单。逐轮测序、文库组成、单体身份、环化形式与 measured enrichment 可以形成结构化实验数据。如果同时保留阴性样本与 assay metadata,计算模型就有机会学习 sequence、chemistry 与 selection behavior 之间的关系。
这类模型可以帮助聚类富集家族、识别 motif、估计不确定性、排列变体优先级,或在实验支持的 chemical space 邻域提出候选。Structure-based 方法能够增加靶标接触与构象约束的假设,generative model 则可在明确化学规则和合成规则下建议新序列。
真正有用的流程是闭环:实验筛选提供数据,模型确定可测试候选的优先级,候选回到合成和实验验证,结果再成为新数据。模型不会替代 target selection、binding assay 或 developability testing,enrichment data 也不应被当作可以跨体系通用的活性标签。
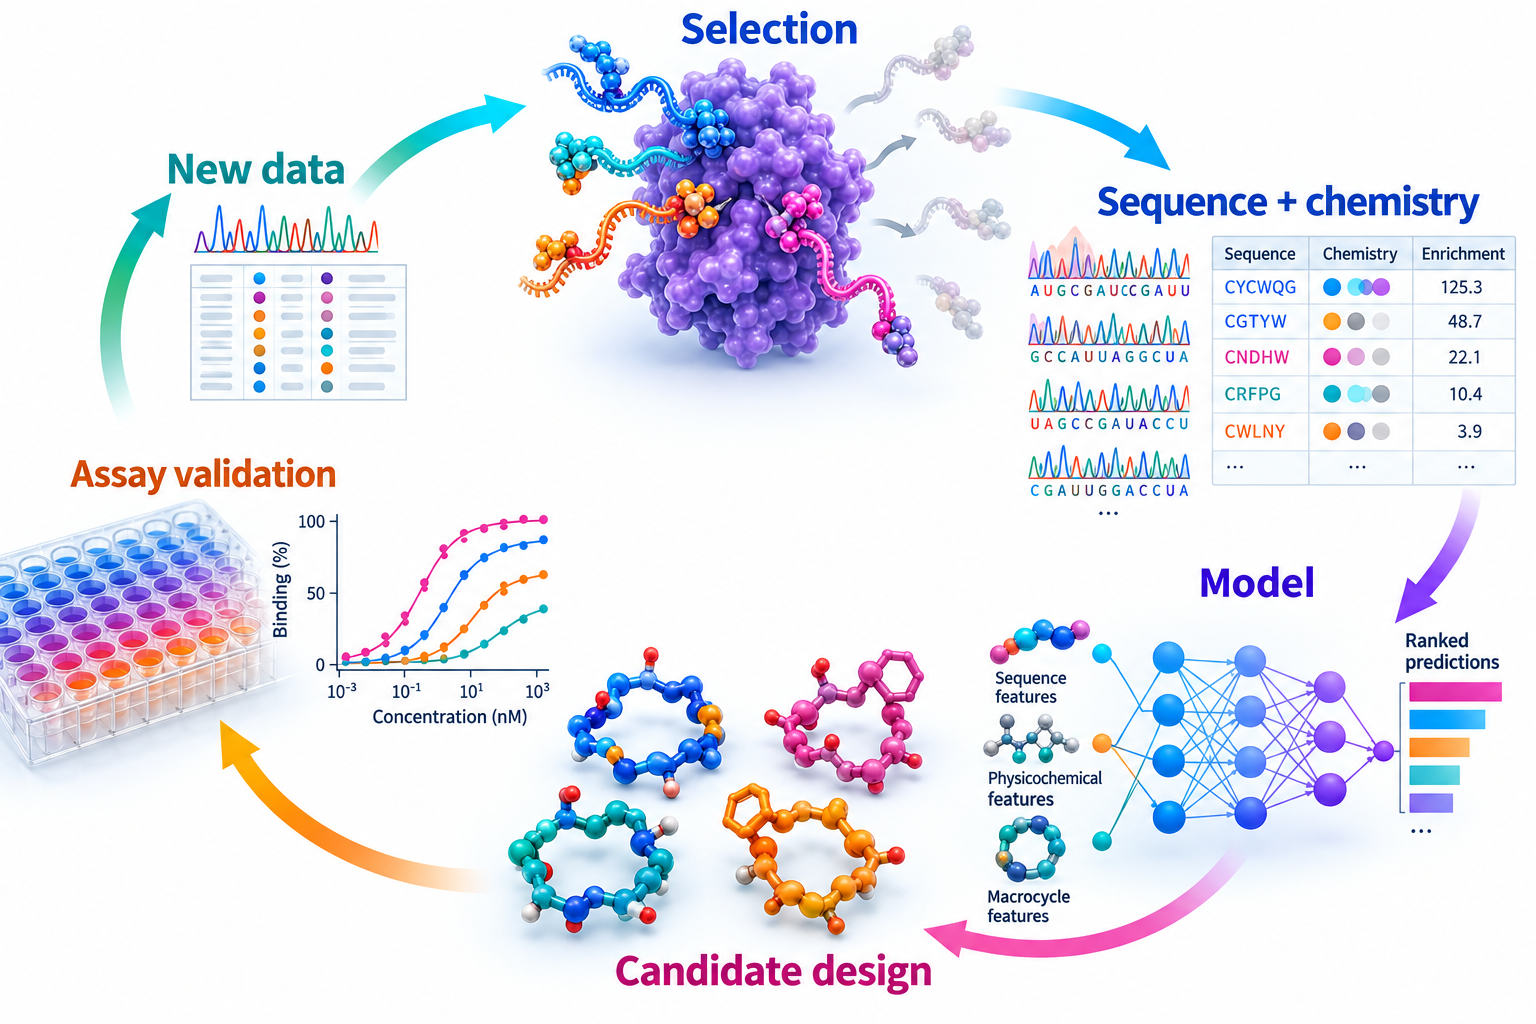
图4. 从实验筛选到数据驱动的设计闭环。模型排列可实验检验的假设优先级,验证结果用于改进下一轮。
这一定位与《用AI辅助多肽设计:从序列到候选药物》相衔接:只有当输入数据、化学约束和实验终点得到清晰定义时,计算方法才最有价值。
如何建立有效的发现项目?
一个稳健项目应从生物学问题出发,而不是从名义文库规模出发。靶标状态、固定方式、counter-target、洗涤强度与回收条件需要与预期结合模式相符。文库应兼容翻译和环化化学,测序方案与对照则应让技术偏差能够被观察。
筛选后,应独立合成不同富集家族的代表成员,而不只是 read count 最高的一条序列。Orthogonal binding assay、competition experiment 与功能测试可以区分真实 target engagement 和筛选伪影。如果目标是可开发 lead,稳定性、溶解性、选择性与 manufacturability 需要尽早进入评价;定制多肽与环肽合成则把 encoded hit 转化为可以直接测试的实物样品。
结语
mRNA Display 通过 puromycin 介导的共价连接,把一条多肽与它自己的序列身份结合起来。其 cell-free 形式支持超大规模文库,而迭代筛选与测序又把分子行为关联到可以回收的遗传信息。环化和经过严谨实现的 NCAA incorporation,可以把可探索空间扩展到天然线性多肽之外。
这项技术最重要的属性仍是实验平台:文库设计、选择对照、测序分析、独立合成和验证共同决定发现是否可靠。计算与生成式方法可以加强这一过程,前提是它们从标注良好的实验数据中学习,并把提出的候选重新送回实验室检验。
参考文献
- Roberts RW, Szostak JW. RNA-peptide fusions for the in vitro selection of peptides and proteins. Proceedings of the National Academy of Sciences of the United States of America. 1997;94(23):12297–12302. doi:10.1073/pnas.94.23.12297
- Nemoto N, Miyamoto-Sato E, Husimi Y, Yanagawa H. In vitro virus: bonding of mRNA bearing puromycin at the 3′-terminal end to the C-terminal end of its encoded protein on the ribosome in vitro. FEBS Letters. 1997;414(2):405–408. doi:10.1016/S0014-5793(97)01026-0
- Wilson DS, Keefe AD, Szostak JW. The use of mRNA display to select high-affinity protein-binding peptides. Proceedings of the National Academy of Sciences of the United States of America. 2001;98(7):3750–3755. doi:10.1073/pnas.061028198
- Huang Y, Wiedmann MM, Suga H. RNA display methods for the discovery of bioactive macrocycles. Chemical Reviews. 2019;119(17):10360–10391. doi:10.1021/acs.chemrev.8b00430
- Peacock H, Suga H. Discovery of de novo macrocyclic peptides by messenger RNA display. Trends in Pharmacological Sciences. 2021;42(5):385–397. doi:10.1016/j.tips.2021.02.004
- Goto Y, Suga H. The RaPID platform for the discovery of pseudo-natural macrocyclic peptides. Accounts of Chemical Research. 2021;54(18):3604–3617. doi:10.1021/acs.accounts.1c00391
下一篇:突破天然氨基酸限制——mRNA Display 如何扩展非天然氨基酸化学空间