mRNA Display 数据如何与 AI 多肽设计结合?
mRNA Display最有价值的AI训练信号不是最后一轮Top序列,而是包含逐轮富集、反筛选、序列家族、NCAA与环化化学及实验验证的完整selection trajectory。
mRNA Display 数据如何与 AI 多肽设计结合?
把mRNA Display数据用于AI,最容易想到的做法是:把最后一轮丰度最高的序列标成“positive”,再生成一批随机序列作为“negative”,训练一个二分类模型。这个方案很简单,却会丢掉实验中最有价值的信息,甚至让模型学错目标。
Final-round abundance同时受到初始丰度、转录与翻译效率、fusion形成、成熟肽生成、NCAA掺入、环化、靶标结合、洗涤、回收、PCR和测序影响;随机序列则不是实验中真正被淘汰的分子。模型可能学到的是library语法、扩增bias或sequence family身份,而不是对靶标的选择性结合。
更合理的起点是保留完整实验历史。mRNA Display产生的是一条trajectory,而不只是一份hit list。 AI应该学习带有化学与筛选上下文的trajectory,再把可检验的优先级返回实验室。
mRNA Display到底产生哪些数据?
一个有用的数据集至少包含五个相互连接的层次。
| 数据层 | 代表性字段 | 价值 |
|---|---|---|
| Sequence | 核苷酸序列、多肽序列、修饰、NCAA位置、环化锚点 | 定义编码身份与预期分子身份 |
| Selection round | R0/input及R1–Rn counts、标准化丰度、enrichment、depletion | 描述序列如何随轮次变化 |
| Conditions | target、counter-target、matrix control、靶标展示方式、stringency、replicate | 定义每个观察值背后的实验压力 |
| Family | cluster、motif、保守位点、可变位点、家族扩增 | 区分共同谱系与独立证据 |
| Validation | Kd、IC50、EC50、competition/functional assay、specificity、stability、合成结果 | 把selection fitness连接到独立测量性质 |
Sequence层应区分nucleotide与peptide identity,因为同义模板在转录、翻译或扩增中可能具有不同表现。对于modified library,还要显式记录NCAA种类与立体化学、骨架修饰、环化锚点、ring topology,以及适用时的codon assignment和incorporation method。
Round-level数据应尽量保留R0或其他input pool测量。R1、R2、R3和后续轮次不是可以互换的样本;它们共同显示一条序列是持续上升、基本不变、逐渐耗竭,还是只在瓶颈之后突然出现。Selection-condition数据则决定这些变化能否被解释:在目标靶标上富集,与在磁珠、tag、同源蛋白或其他counter-target上富集,并不是同一种phenotype。
最后,orthogonal validation数据的价值通常高于单独的sequencing abundance。测序记录的是分子通过display流程后的survival;实测Kd、功能响应、血清稳定性或合成结果,则是在另一个assay中测量的另一种性质。把这些endpoint分开,才能避免模型把selection signal包装成binding constant或developability结论。
为什么final-round read count不是binding constant?
最终read count是多重过滤器共同作用的累计结果:
starting abundance → transcription → translation → fusion formation → chemical maturation → target interaction → washing → recovery → amplification → sequencing
一个真正结合较好的多肽,可能因为R0丰度很低、翻译效率不足或环化不完全而很少;另一个结合一般的序列,可能因为起始丰度高、扩增效率好或容易非特异黏附而占据final pool。两条路径都会改变最终count。
因此必须明确:
- read count不等于affinity;
- enrichment不等于Kd;
- top sequence不自动等于best peptide。
没有这一区分,模型学到的是“通过整个protocol的surrogate”。它仍可用于candidate ranking,但必须被称为selection fitness,并按这一目标验证;不能悄悄解释成精确affinity、potency、PK、口服生物利用度、毒性或人体疗效。
关于各实验步骤如何改变群体,可参阅《从随机肽库到候选肽:mRNA Display一轮筛选到底发生了什么?》。
Enrichment trajectory比单轮raw abundance更有信息
跨轮次的相对变化通常比单个pool的丰度更有解释力。一个R0中很少、但在R1、R2、R3连续上升的序列,与一个起始就很多、随后标准化丰度基本不变的序列,代表完全不同的过程。
实际分析可以使用log enrichment或其他稳定化的相对变化指标。建模前还应处理sequencing-depth normalization、零计数或极低计数的pseudocount、low-count uncertainty、dropout以及replicate consistency。这些处理不会把enrichment变成affinity,只是减少可避免的数值伪影,让观察到的trajectory更可靠。
| Sequence family | R0 | R1 | R2 | R3 | Counter-selection | Interpretation |
|---|---|---|---|---|---|---|
| Family A | low | ↑ | ↑↑ | ↑↑↑ | low | target-enriched |
| Family B | medium | ↑ | ↑↑ | ↑↑ | ↑↑ | 可能为非特异或off-target富集 |
| Family C | high | stable | stable | stable | low | 丰度高,但没有明显持续富集 |
仅为示意数据;表中符号并非公司真实实验结果。
Depletion与counter-selection也是训练数据
只看positive selection,无法区分target preference与generic stickiness。Negative/counter-selection能够揭示matrix binding、tag binding、off-target或同源蛋白结合,以及非特异疏水滞留。
一个在target上富集、同时也在counter-target上富集的多肽,不等同于selective binder。 有用的模型应比较positive与counter-selection trajectory,排序target-vs-counter-target preference,并标记在多个control中都表现突出的家族。这样,计算任务就从“找出任何能留下来的分子”转向“优先选择符合预期选择性轮廓的分子”。
实验来源的negative也比任意random sequence更有信息。更合理的lower-fitness例子包括:depleted library members、起始计数足够但未富集的成员、counter-selected sequences、实验无活性的variants,以及失去活性的family mutations。但“没有富集”仍不自动等于true non-binder:低起始representation、sampling limit和技术损失都会带来label uncertainty。训练数据应保留这种不确定性,而不是强迫所有序列进入绝对二分类。
Ranking通常比binary classification更合适
mRNA Display提供的多为relative evidence,因此更适合ranking或fitness prediction。例如:
- 预测relative enrichment或continued enrichment probability;
- 在一个sequence family内部排序候选;
- 预测target-vs-counter-target preference;
- 确定哪些variants应优先重新合成和独立验证;
- 选择下一轮focused library中信息量高的成员。
这些目标比通用的“binder/non-binder”标签更贴近实验真正观察到的信号,也便于后续加入selection fitness、specificity、stability和synthesizability等多目标,而不把一个分数误称为所有性质的直接测量。
Sequence family必须进入分析与评估设计
mRNA Display campaign通常产生相关sequence families,而不是彼此孤立的赢家。Family alignment可以揭示高度保守位点、半保守位点、tolerant positions、残基类别偏好,以及跨轮次的家族扩增。这些信息可用于constrained generation、site-specific mutation、NCAA substitution和focused-library design。
它同时带来严重的模型评估风险:如果高度相似的family members被随机分入train和test,模型只要识别已经见过的家族就能得到很高分。这是data leakage,不是模型能够推广到新chemotype的证据。
数据拆分因此应考虑sequence identity和cluster,也要考虑experimental round、target与campaign。更有意义的测试包括family-held-out、campaign-held-out,以及在科学问题适用时的target-held-out evaluation。Evaluation应该检验generalization,而不是对sequence family的memorization。
传统motif analysis回答“每个位置经常出现什么残基”;AI模型还可能捕捉context dependence、residue interactions和non-additive/epistatic effects。这些模式可以改进预测与设计,但不能仅凭相关性就声称已经解释causal molecular mechanism。
面向NCAA与环肽的chemistry-aware representation
当library包含非天然氨基酸时,如果把所有特殊残基只编码为X1、X2或同一个unknown token,就会丢掉实验原本要探索的化学差异。数据至少应保留:NCAA identity、stereochemistry、N-methylation status、side-chain chemistry、charge、hydrophobicity、steric class、cyclization role、codon assignment和适用的incorporation method。
Chemistry-aware模型可以组合residue token与physicochemical/structural descriptors,在合适时加入chemical fingerprint、backbone-modification flag和stereochemistry。模型至少应区分D-AA、N-methyl AA、Aib-like constrained residues、aromatic NCAA和cyclization handles等不同角色。相关实验基础可参阅《为什么mRNA Display特别适合非天然氨基酸和环肽发现?》与《非天然氨基酸如何用于多肽优化:不只是提高稳定性》。
环肽还需要额外一层表示。两个linear residue string完全相同的分子,如果anchor positions、closure chemistry、linker或ring topology不同,就可能是不同化合物。因此,cyclization应被表示为molecular connectivity,而不是附加在线性序列后的自由文本标签。最小记录应包括锚点位置、环化化学、ring topology和适用时的linker identity。
Structure data可以进一步加入target conformation、peptide conformation、predicted contacts、interface score或pose consistency。Structure-conditioned design可帮助保留hotspot或提出相容突变;但在没有实验结构时,predicted peptide structure或docking pose仍是假设,其不确定性必须传递到后续决策。
三类实用AI任务
任务一:Candidate ranking
输入为sequence与chemistry、round-by-round enrichment trajectory、counter-selection数据和replicate context;输出是可追踪、可解释的重新合成优先级。这通常是最直接、风险最低的应用,因为它缩小一个已有实验结果,而不是声称从零创造活性。
任务二:Local optimization
从经过验证或重复富集的family出发,模型可排序邻近variants,用于改善affinity、selectivity、stability或合成表现,引入NCAA,或比较不同环化方案。保守位点受到保护,tolerant positions用于多样化,使提案停留在实验支持的sequence space附近。下游原则可继续参考《已有一个多肽,AI可以如何优化它?》和《AI设计的多肽,为什么还必须经过“可合成性”筛选?》。
任务三:Generative design
当平台积累了足够广、经过整理的target–peptide、selection和validation数据后,generative model可以在明确化学约束下提出候选。一次campaign通常不足以证明模型具有广泛生成能力。生成分子仍需经过library compatibility、chemistry、topology、diversity和synthesis feasibility筛选,并接受prospective testing。
对于数据量有限的平台,candidate ranking、family analysis、mutation prioritization和focused-library design通常比立即训练大型生成模型更现实。
AI不仅可以设计下一条peptide,也可以设计下一代library
一旦允许多个NCAA和多个可变位点,组合空间会快速爆炸。AI的价值不是生成更多字符串,而是缩小搜索空间,同时保留信息性diversity与chemical feasibility。
一个focused library可以固定保守binding motif,只在tolerant positions变化,并根据family evidence与翻译限制分配特定天然氨基酸、D-AA、N-methyl residues或其他允许的NCAA。输出不是一条“最佳”分子,而是一个被有意构造的下一轮实验。
合成并测试20–50个信息量高的候选,往往比生成100,000条未经验证的virtual sequence更能改进下一轮模型。实验反馈是稀缺、target-specific的信息;虚拟候选只是hypothesis。设计目标应包含information gain,而不只是predicted score。
Design–Build–Select/Test–Learn闭环
端到端流程可以组织为:
raw mRNA Display data → QC/normalization → sequence + chemistry representation → round-by-round enrichment → positive/counter-selection comparison → sequence family clustering → model training/ranking → candidate或focused-library design → synthesis、display或independent assay → experimental feedback → model update
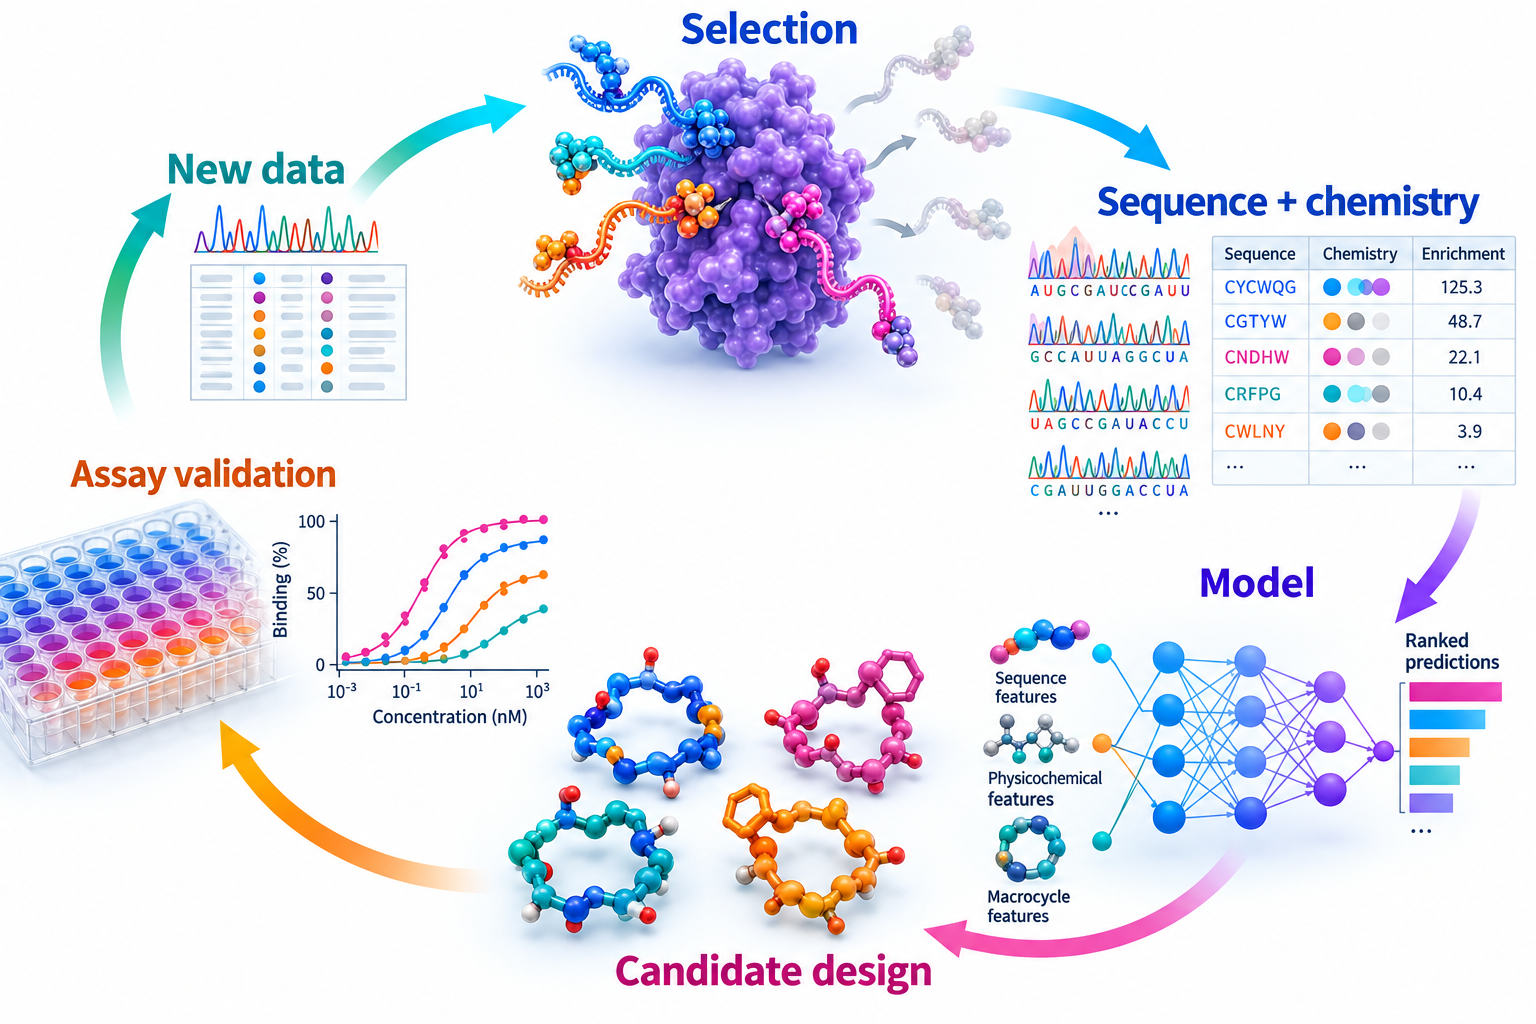
图1. mRNA Display数据与AI多肽设计形成实验反馈闭环。模型排列可检验假设的优先级;selection与independent assay提供不同但互补的反馈。
这是一条Design → Build → Select/Test → Learn → Redesign循环。这里必须区分selection与independent assay:让focused library再次进入mRNA Display,会产生新的selection-fitness trajectory;重新合成离散候选并测量binding或function,则产生orthogonal label。两者都能更新模型,但不能在缺少endpoint metadata时混为一谈。
Data quality与provenance先于模型复杂度
一个可复用数据集需要stable sequence identifiers、normalized molecular representations、modification/topology records、round和target IDs、selection type、counts与sequencing depth、replicate IDs、library chemistry、assay results和provenance。
每个training example都应可追溯到具体campaign、round、target、positive/negative selection、library、chemistry、assay和processing version,并标明数值来自experimental、derived还是simulated。结构混乱的实验数据,无法靠更复杂的模型挽救。
Simulated data适合pipeline development、schema testing、model architecture prototyping和workflow validation;它不能证明模型已经能够在真实mRNA Display化学空间和bias结构中完成发现。模拟与实验记录必须可以区分,discovery capability的结论最终必须来自真实selection与assay数据。
Model evaluation最终要落到prospective validation
Historical test-set performance有价值,但不充分。Random split可能通过family overlap或campaign-specific shortcut夸大结果。Family-held-out和campaign-held-out测试更强;当预期用途是迁移到新靶标时,也可以进行合适的target-held-out evaluation。
最强证据是prospective validation:模型在未知结果时提出优先候选;候选被合成、选择或测定;再把真实hit rate、enrichment、selectivity或其他预先定义endpoint与合理baseline比较。它直接回答最重要的操作问题——模型是否改善了下一次实验决策?
从selection signal到developable peptide
High enrichment不保证容易合成、溶解性良好、具有蛋白酶或血清稳定性、选择性高、低毒或可透膜。完成基于selection的排序后,开发仍需要更多证据,并通常需要把physicochemical properties、structure、synthesis feasibility与independent assay data放进多目标设计。
AI不能仅凭sequencing trajectory声称能够可靠输出精确Kd、IC50、PK、口服生物利用度、毒性或人体疗效。它最直接的作用是selection-fitness analysis、candidate prioritization与experimental design。定制多肽与环肽合成随后可把encoded或designed candidates转化为实物样品,用于identity、purity、binding与functional testing。
结语
mRNA Display与AI的真正结合,不是把最后一轮测序结果交给一个模型,而是把整个selection process转换成结构化、可追踪、带实验上下文的数据。
当enrichment、depletion、sequence family、positional tolerance、非天然氨基酸、环化方式和独立实验验证能够被统一表示时,AI才可能从“分析筛选结果”进一步进入“设计下一轮实验”。这条路径应从严谨的candidate ranking与focused-library design开始,并最终由prospective实验结果评判。
参考文献
- Roberts RW, Szostak JW. RNA-peptide fusions for the in vitro selection of peptides and proteins. PNAS. 1997;94:12297–12302. doi:10.1073/pnas.94.23.12297
- Blanco C, Verbanic S, Seelig B, Chen IA. High throughput sequencing of in vitro selections of mRNA-displayed peptides: data analysis and applications. Physical Chemistry Chemical Physics. 2020;22:6492–6506. doi:10.1039/C9CP05912A
- Kamalinia G, et al. Directing evolution of novel ligands by mRNA display. Chemical Society Reviews. 2021;50:9055–9103. doi:10.1039/D1CS00160D
- Josephson K, Ricardo A, Szostak JW. mRNA display: from basic principles to macrocycle drug discovery. Drug Discovery Today. 2014;19:388–399. doi:10.1016/j.drudis.2013.10.011
- Li S, Millward S, Roberts RW. In Vitro Selection of mRNA Display Libraries Containing an Unnatural Amino Acid. Journal of the American Chemical Society. 2002;124:9972–9973. doi:10.1021/ja026789q
- Huang Y, Wiedmann MM, Suga H. RNA display methods for the discovery of bioactive macrocycles. Chemical Reviews. 2019;119:10360–10391. doi:10.1021/acs.chemrev.8b00430
- Vinogradov AA, Chang JS, Onaka H, Goto Y, Suga H. Accurate Models of Substrate Preferences of Post-Translational Modification Enzymes from a Combination of mRNA Display and Deep Learning. ACS Central Science. 2022;8:814–824. doi:10.1021/acscentsci.2c00223
- Smith TP, Bhushan B, Granata D, et al. Identification and engineering of potent cyclic peptides with selective or promiscuous binding through biochemical profiling and bioinformatic data analysis. RSC Chemical Biology. 2024;5:12–18. doi:10.1039/D3CB00168G
希望把mRNA Display筛选结果进一步用于候选设计?
如果您的项目已经产生mRNA Display、NGS或候选多肽数据,我们可以从序列家族、富集趋势、非天然氨基酸、环化方式和后续合成验证等角度进行分析,并支持下一轮多肽设计与定制合成。